La productividad de cualquier organización depende del rendimiento de los ordenadores de sus empleados.
Si esos ordenadores funcionan con lentitud o se bloquean, la productividad de los empleados se verá afectada y la agilidad general de la organización disminuirá.
Dado lo mucho que está en juego, la supervisión del rendimiento constituye una capacidad fundamental para cualquier organización interesada en sacar el máximo partido a su personal y a su tecnología.
A continuación le presentamos siete prácticas recomendadas para garantizar que su organización supervise de forma eficaz y eficiente el rendimiento de los terminales , como los ordenadores de los empleados, los servidores y otros dispositivos.
1. Supervise todo tipo de dispositivos finales
Resulta tentador simplificar las cosas. Supongamos que el 90 % de los dispositivos de su organización son equipos con Windows. Usted invierte en herramientas y establece procesos para supervisar esos equipos con Windows.
Por supuesto, existen servidores Linux de , pero no se encuentran en los cubículos ni en las oficinas domésticas de las personas. Y a algunos de los directivos les encantan sus Mac. Va a confiar en que esas máquinas funcionan bien; al fin y al cabo, nadie se queja. Y dispone de numerosos gráficos que demuestran el excelente trabajo que está realizando con los equipos Windows.
Pero esos otros criterios de valoración también son importantes. Y cuando se producen problemas de rendimiento, estos pueden afectar a un gran número de usuarios, ya sea de forma directa o indirecta. (Cuando el ordenador Mac del director financiero se bloquee y no pueda autorizar las compras, muchas personas se verán afectadas.)
Así pues, de una forma u otra, asegúrese de disponer de las herramientas y los procesos necesarios para supervisar todos los tipos de dispositivos finales de su organización: Windows, macOS y Linux.
2. Supervise todos los puntos finales (sí, todos los puntos finales )
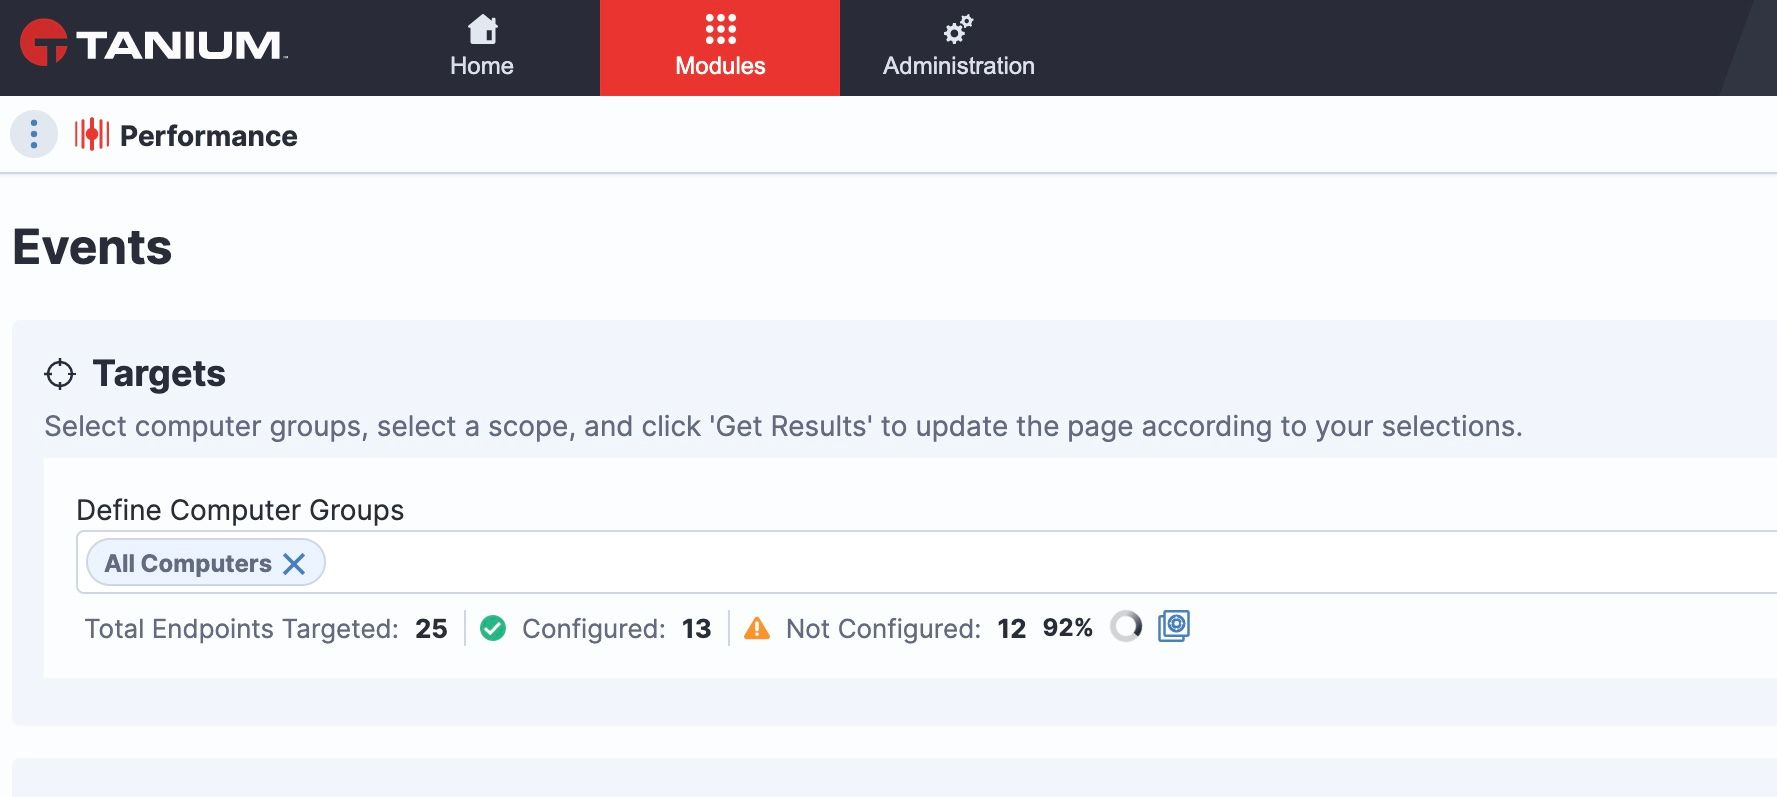
Aunque disponga de herramientas de supervisión para cada tipo de terminal de su organización, es muy probable que siga pasando por alto algunos —o muchos— de sus terminales. Lo digo porque, cuando visitamos empresas para evaluar sus prácticas de supervisión del rendimiento, solemos constatar que alrededor del 10-20 % de los terminales quedan excluidos de los informes de supervisión del rendimiento.
Esto significa que el 10-20 % de los dispositivos finales corren el riesgo de ofrecer un rendimiento deficiente, lo que provoca que los empleados que los utilizan se sientan frustrados y sean menos productivos.
De una forma u otra, establezca herramientas y procesos que le permitan supervisar realmente todos los terminales de su organización.
3. Obtenga una visión general
Una cosa es localizar todos los puntos finales. Otra cosa muy distinta es permitir que los responsables de TI y de las unidades de negocio dispongan de una «visión global» de todos los terminales gestionados.
Para realizar un seguimiento eficaz del rendimiento, a menudo es necesario tener una visión de conjunto: esa vista general del panel de control que le permite comprobar que, por ejemplo, la oficina de Chicago funciona correctamente, pero que en Cincinnati hay terminales que se bloquean debido a errores de memoria tras la actualización de la aplicación realizada anoche.
Para supervisar el rendimiento en toda la empresa, asegúrese de poder obtener una visión global de la misma, así como un análisis detallado de cualquier terminal que presente problemas de rendimiento.
4. Procure que sea sencillo para los usuarios finales
En muchas organizaciones, cuando un empleado comunica un problema de rendimiento al servicio de asistencia técnica, las interrupciones en su trabajo no han hecho más que empezar. La mayoría de las plataformas de supervisión del rendimiento obligan a los ingenieros de TI a interrumpir el trabajo de los empleados o a competir con él para resolver el problema.
Es posible que el empleado tenga que aceptar una solicitud para instalar una nueva aplicación de diagnóstico o de control remoto en su dispositivo. Es posible que no se pueda iniciar la investigación del problema hasta que finalicen las tareas oficiales —es decir, las realizadas en el marco de las funciones del empleado—. Si el problema era intermitente y se debía a cualquier actividad que estuviera realizando el empleado, se ha perdido la oportunidad óptima para solucionar el problema.
¿Un enfoque más adecuado? Utilice herramientas que permitan a los ingenieros investigar lo que está ocurriendo en el terminal sin interrumpir al usuario. Permita que los ingenieros supervisen los procesos, el uso de la memoria y otros datos clave sin que el empleado tenga que mover un dedo, instalar un cliente, ir pasando por los cuadros de diálogo ni pasar una hora al teléfono.
5. Registre a nivel local, resuelva problemas a nivel global
Una de las razones por las que tantas plataformas de supervisión del rendimiento recurren a técnicas de investigación intrusivas es que tienen poco o ningún acceso a los datos sobre la actividad de los terminales hasta que los ingenieros se conectan realmente a ellos a través de la red.
Este enfoque presenta dos inconvenientes importantes: interrumpe a los usuarios y limita los datos a los que pueden acceder los ingenieros. Si un problema es intermitente o está relacionado de alguna manera con otra actividad que tuvo lugar horas o días antes, es probable que el ingeniero encargado de la investigación pase por alto estos detalles.
Un enfoque alternativo consiste en que los puntos finales registren los datos de rendimiento de forma local, de modo que, cuando los ingenieros investiguen los problemas, puedan encontrar de inmediato una gran cantidad de datos en los que basarse en un almacén de datos local.
Dado que los datos ya se han recopilado, los ingenieros no tienen que interrumpir a los usuarios para recopilarlos. Además, dado que los datos se almacenan localmente, los ingenieros pueden acceder a ellos sin necesidad de que todos los terminales transmitan continuamente métricas detalladas a una consola de gestión central.
Sin embargo, incluso sin una recopilación colosal de datos a través de las redes —que provoque atascos de tráfico—, los ingenieros pueden solucionar los problemas del terminal desde cualquier lugar: una red LAN o WAN local, un centro de asistencia técnica, un centro de control de operaciones de seguridad o incluso una oficina en casa.
El resultado es una mejor información para la resolución de incidencias, una resolución más rápida de los problemas y una interacción más cómoda tanto para los usuarios finales como para los ingenieros.
6. Ayude al equipo de desarrollo interno
Al recopilar y compartir información detallada sobre el rendimiento de los terminales, el equipo de operaciones de TI tiene la oportunidad de ayudar al equipo de desarrollo interno a resolver los problemas de las aplicaciones que están desarrollando para los empleados.
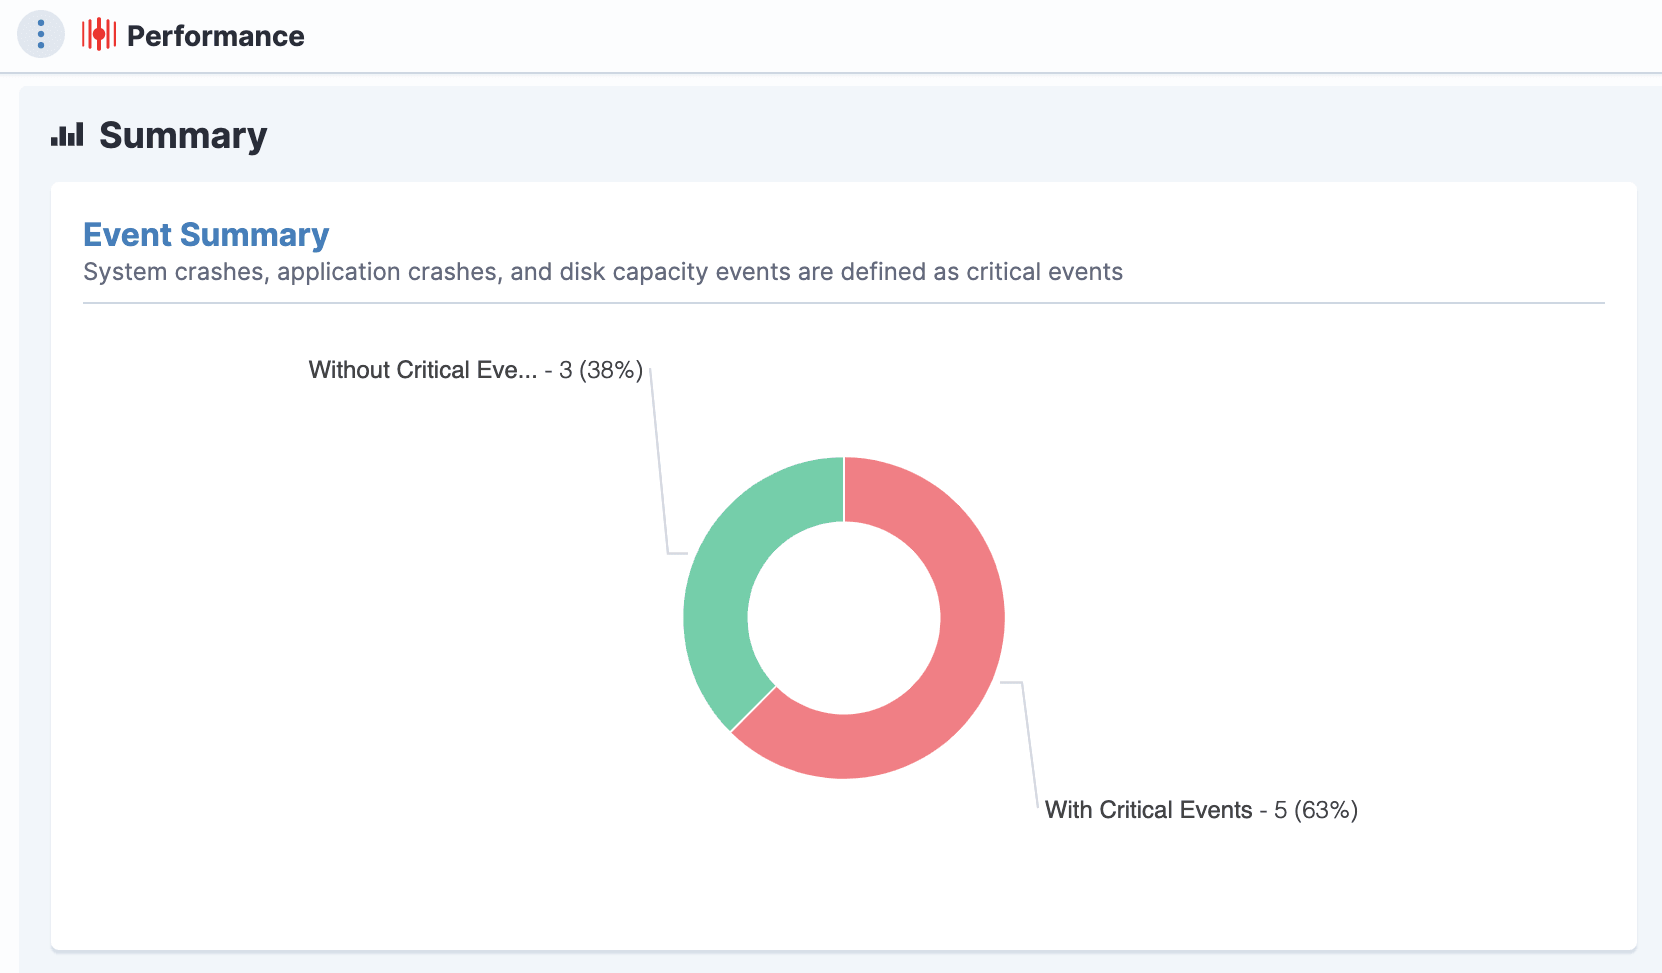
Los datos de rendimiento en tiempo real e históricos sobre la ejecución de procesos, la asignación de memoria, el uso del disco y otras métricas clave en cientos o miles de terminales pueden ayudar a los desarrolladores a identificar y solucionar problemas que no podían detectar ni caracterizar adecuadamente en implementaciones más limitadas en entornos de prueba.
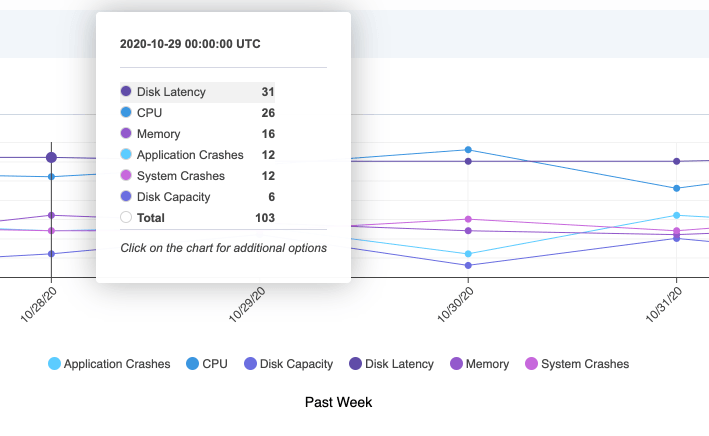
El seguimiento del rendimiento podría considerarse una herramienta general aplicable a todos los empleados, pero también resulta una herramienta valiosa para las organizaciones de desarrollo, aunque no forme parte oficialmente de un paquete de desarrollo de software.
7. Reducir el tiempo medio de reparación (MTTR)
El MTTR ( ) es, quizás, el indicador definitivo de cualquier práctica de supervisión del rendimiento.
Cuando surge un problema, ¿con qué rapidez puede resolverlo el equipo de TI? ¿Pueden encontrar la información que necesitan de forma rápida y sencilla? ¿Podrán encontrarlo sin interrumpir el trabajo de los empleados afectados por el problema?
El seguimiento de indicadores como estos permite a las organizaciones de TI evaluar el valor de sus herramientas y procedimientos de rendimiento. Si el personal, los procesos y la tecnología que utiliza para la supervisión del rendimiento no reducen el MTTR, eso indica que su personal, sus procesos y su tecnología aún necesitan ayuda.
Si sigue estas prácticas recomendadas, reducirá el MTTR, optimizará el rendimiento sin interrumpir el trabajo diario de los empleados, ayudará a los equipos de desarrollo internos a resolver más rápidamente problemas sutiles y se beneficiará de una respuesta más rápida ante vulnerabilidades de seguridad y otros riesgos operativos.
Para obtener más información, consulte mi entrada anterior del blog « » y «10 formas en las que Tanium mejora la supervisión del rendimiento» en.
Si está listo para verlo en acción, visite y solicite una demostración en hoy mismo.

